

 400-060-5200



科脉携手腾讯智慧零售达成战略合作
2026.07.27
一家 2000 平米的社区超市,SKU 通常在 8000 到 12000 之间,每年要汰换 20% 到 30%,也就是两千个左右的单品要下、要进。这个决定谁做?采购。依据是什么?“这个卖得还行”“那个厂家支持力度大”“上次试过类似的不好卖”。
问题不在采购不专业,在判断不可复制。换一个采购,同一批数据可能给出相反结论,企业还没法判断哪个更对。科脉公布的三个数是:坪效提升 30%、库存周转提速 20%—30%、销售额增长 15%—25%。三个数来自“改结构”,不是“搞促销”,底下那节细说。
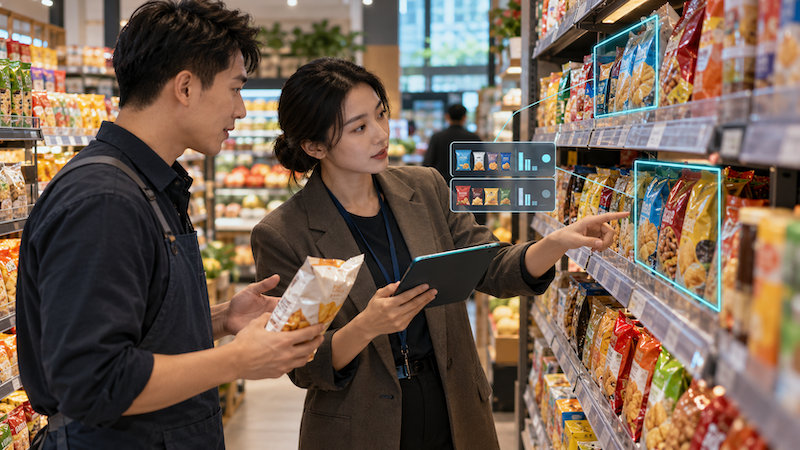
是卖不动的 SKU。
货架有限,租金固定。一个卖不动的单品占的不是一格货架,是这一格本该产生的周转。它安安静静躺在那里,销量不难看,毛利极低,占两格排面——在销量排行上,它甚至排在中游。
所以按销量排行找滞销,永远找不全。这不是数据量的问题,是维度的问题:只看销量,看不见毛利和排面。
找滞销,靠月度排行。排行只看销量,不看毛利,也不看占了多少排面。一个销量中等、毛利极低、占两格货架的单品,在排行上并不难看,因此也不会被挑出来。
判汰换,靠采购经验。经验有价值,但不可复制、不可审计。同一批数据,两个采购可能给出相反的结论,而企业无法判断哪个更对。更麻烦的是,出了偏差也回溯不到哪一步判断错了。
试新品,靠厂家推荐。上新之后没有明确的观察周期和淘汰标准,新品就成了“长期观察对象”,一放两年,最后以清仓收场。
三个环节的共同成本不是人力,是决策无据。错了不知道错在哪,对了也不知道对在哪,因此没法迭代。
找滞销:三个维度一起看。销量 × 毛利 × 排面,合成一次打分,把“占着好位置却不产出”的单品挑出来。这一步的价值不是算得多准,是让“占位不产出”这件事第一次变成可见的。
判汰换:结论后面必须跟依据。动销天数、毛利率、同类替代品表现,三列一起给。采购的判断从“我觉得”变成“数据显示”,而且这个“数据显示”是可以被同事复核的。
试新品:先定观察窗口。比如 4 周或 8 周,到期自动给结论:继续、加排面,还是下架。新品不和成熟单品用同一套权重,这一点很重要,否则新品永远打不过老品。
第二点是可用性的关键。只给结论不给依据的系统,采购用一次就不会再用第二次——因为没法反驳,也就没法信任。
| 环节 | 以前怎么做 | 现在怎么做 | 指标 | 数字出处 |
|---|---|---|---|---|
| 滞销识别 | 月度销量排行 | 销量 × 毛利 × 排面三维打分 | 识别维度由 1 增至 3 | 产品能力,不是效果数 |
| 汰换决策 | 依赖采购个人经验 | 结论附三条依据,可复核 | 决策留痕、可回溯 | 产品能力,不是效果数 |
| 店效 | — | — | 坪效提升 30% | 科脉公布 |
| 资金效率 | — | — | 库存周转提速 20%—30% | 科脉公布 |
| 业绩 | — | — | 销售额增长 15%—25% | 科脉公布 |
这三个数,是改结构改出来的,不是打折冲出来的。坪效涨,是因为同样两格排面换成了动销更快的品;周转快了,是因为两个月不动销的长尾被砍掉了;销售额跟着上来,是货架效率变了,不是把明年的量提前卖。品类不一样,腾挪余地差得很远:长尾重、堆头多的品类空间大,周转本来就快的品类小得多。你自己品类站在哪个位置,跑一遍就知道。
不谈供应商,不定价格带。选品的商业判断仍然在人手上——它做的是把判断需要的依据,从四张表压成一个结论。
还有一条必须说清:商品运营和补货是两件事。前者决定“卖什么”,后者决定“进多少”。混在一起谈,两边都谈不清——这也是科脉智灵把这两件事拆成两个智能体的原因。
抽样对照。从滞销清单里随机抽 50 个 SKU,让采购逐个判断“该不该下”。判断一致的比例,就是这套打分的可用度。低于七成,说明权重和品类特性不匹配,先调权重再铺开。
看依据。每条建议后面有没有动销天数、毛利率、替代品这三列。只有结论没有依据的,采购不会用第二次。
看周转。一个月后对同一品类做周转天数前后对比。记得剔掉促销月——促销月周转天然更快,不剔除会把效果放大。
建议从休闲零食开始:SKU 多、汰换快、单价低、试错成本小。三维打分跑一个月,和采购的实际汰换清单对一遍。差在哪,就是你的品类特性所在——可能排面权重给高了,也可能毛利权重给低了。
跑通一个品类再复制。品类之间的权重不能直接套:生鲜看损耗和效期,标品看毛利和周转,专卖看连带率。一套参数打天下,效果一定打折。
和智能补货什么区别?商品运营决定“卖什么”,管 SKU 去留与排面;智能补货决定“进多少”,管单店单品订货量。数据同源,决策对象不同。
滞销清单怎么算的?按销量、毛利、排面三个维度综合打分,不是单看销量排行。因此“销量中等但占两格货架、毛利极低”的单品也会被识别出来——这类单品在传统排行上通常是隐形的。
这三个数,我们的品类够得着吗?看起点。长尾多、堆头挤、周转天数明显偏长的,20%—30% 不是难事;周转本来就压得很紧的品类,别指望还有这么大空间,先看优化结构能腾出多少排面和现金。判断方法很简单:把 SKU 按销量排一遍,看后 30% 贡献了多少销售——占比越低,可动的地方越大。
数据要多完整才能用?至少需要单品级销售流水、成本与毛利、货架排面数三类数据,时间跨度建议不少于 12 个月。排面数据缺失时,“占位不产出”这一类问题识别不出来。
会不会把有潜力的新品砍掉?新品走独立的新品试销逻辑,先设观察窗口,到期再判断,不与成熟单品共用权重。企业也可以设置为“建议仅供参考”,由采购逐条确认,不做自动下架。



 粤公网安备 44030502000271号